
作为本科数据科学背景较重的学生,我们熟记于“相关不等于因果”这句话,并常在分析中运用相关性的方法,而闭口不谈因果关系,因而因果推断不常为我们所熟知。在通往AGI的道路上,仅靠基于相关性的机器学习是不足以的,因果推断则成为了突破“强人工智能”实现阻碍的关键方向。作为该领域的领军者,图灵奖获得者珀尔(Judea Pearl)的这本《为什么:关于因果关系的新科学》是入门该领域的完美书籍,它既有科普性质,又能为该领域研究者起到梳理历史、启发思路的作用。
感谢我的本科导师彭珍教授的赠书。
希望你能与我一样迫不及待地去寻求答案。——朱迪亚·珀尔
Introduction:从相关到因果
不管你是否了解数据科学,你可能都听过“相关不等于因果”这个说法。诚然,要想预测未来的某件事情,我们有两种思路:
- 基于相关(关联):我知道当 X 出现的时候,Y 大概率也会出现
- 基于因果:我知道 X 会导致 Y
注意到:基于相关方法中,概率是一个重要的概念,它对静态世界的观察结果。然而,因果是指原因与结果之间的关系,因此不能被简化为概率:X提高了Y的概率 ≠ X导致了Y,X只是增加Y的可能性,而非让其必然发生。
因此,我们说:相关是概率上的数据观察结果,而因果关系则是更深一层的数据生成机制,即“相关不等于因果”。因此,数据不是万能的,不足以解决因果问题,需要研究数据的生成过程。
如果仔细思考,你会发现:在传统统计学的科学词汇中,无法准确描述因果关系及其相关问题。例如:方程式能表达几个量之间的相关关系,却无法描述其因果,因为位置可自由变换。因此,迫切需要提出新的语言、创造新的研究方法,以研究因果关系。由此诞生了因果推断学科,它的主要内容有:
- 因果推断的语言:通过因果模型描述数据的生成过程,如因果图、数学方程、文字假设
- 因果推断方法:如后门准则、do算子等,能够在不实施实际干预的前提下,预测干预的结果
- 反事实的算法化:通过结构因果模型模拟人类的反思性思考
以上也是本书的主要内容。下面按逻辑结构予以介绍:
因果推断学科的诞生
在因果推断学科成形之前,经历了曲折的探索:
- 弗朗西斯·高尔顿:发明了回归和相关这两个统计概念,但一定程度上阻碍了统计学中对因果性的讨论,使得统计学禁锢在了因果之梯的第一层
- 卡尔·皮尔逊:提出了相关系数的计算方法、卡方分布及相关的检验方法,但他将因果关系视为一种“迷信”,认为科学只应研究相关关系
- 休厄尔·赖特:20世纪20年代提出路径分析(又称:通径分析)的生物学家,在研究豚鼠毛色遗传时,首次建立了一套根据数据回答因果问题的数学方法
其中,赖特所提出的路径分析方法的核心思想是:如果已知变量之间的因果结构,就可以通过联立方程组来表示它。下面其进行演示:
- 假设有三个变量,其因果结构如下:
$$X → Y → Z,且 X → Z$$ - 将其转换为数学表达,则对应的结构方程为:
$$Y = aX + U_Y$$
$$Z = bY + cX + U_Z$$
其中 $a, b, c$ 是路径系数,$U_Y, U_Z$ 是外生扰动项。这些方程直接表示了变量之间的因果机制,每个方程描述一个变量如何被它的直接原因所决定。 - 通过联立方程组的形式,实现通过观测数据的相关系数来估计路径系数。联立后形式如下:
$$Z = b(aX + U_Y) + cX + U_Z = cX+abX+bU_Y+U_Z$$ - 因此:$X$ 与 $Z$ 的相关系数 $r_{XZ}$ 就可以分解为两条路径的贡献:
$$r_{XZ} = c + ab$$
区别于普通的线性回归方法,赖特通过此分解实现了:将统计学上的 $X$ 与 $Z$ 的相关系数 $r_{XZ}$ ,分解成了直接效应 $c$ 和间接效应 $ab$。珀尔对此给予极高评价,认为这是“20世纪科学迈向因果之梯第二层的第一步”。
理论基础——因果关系之梯
在因果推断学科中,因果关系的分类是一切理论的基础。珀尔按其所属者的能力,将因果关系的三个层级区分如下:
- 关联:观察“发生了什么”,并基于被动观察做出预测(X→Y),对应观察(seeing,发现环境中规律)的能力
- 干预:预测“改变某因素会怎样”,并根据预测结果选择行为,对应行动(doing)的能力
- 反事实:推演“如果当初……会怎样”,对应想象(imagining)能力
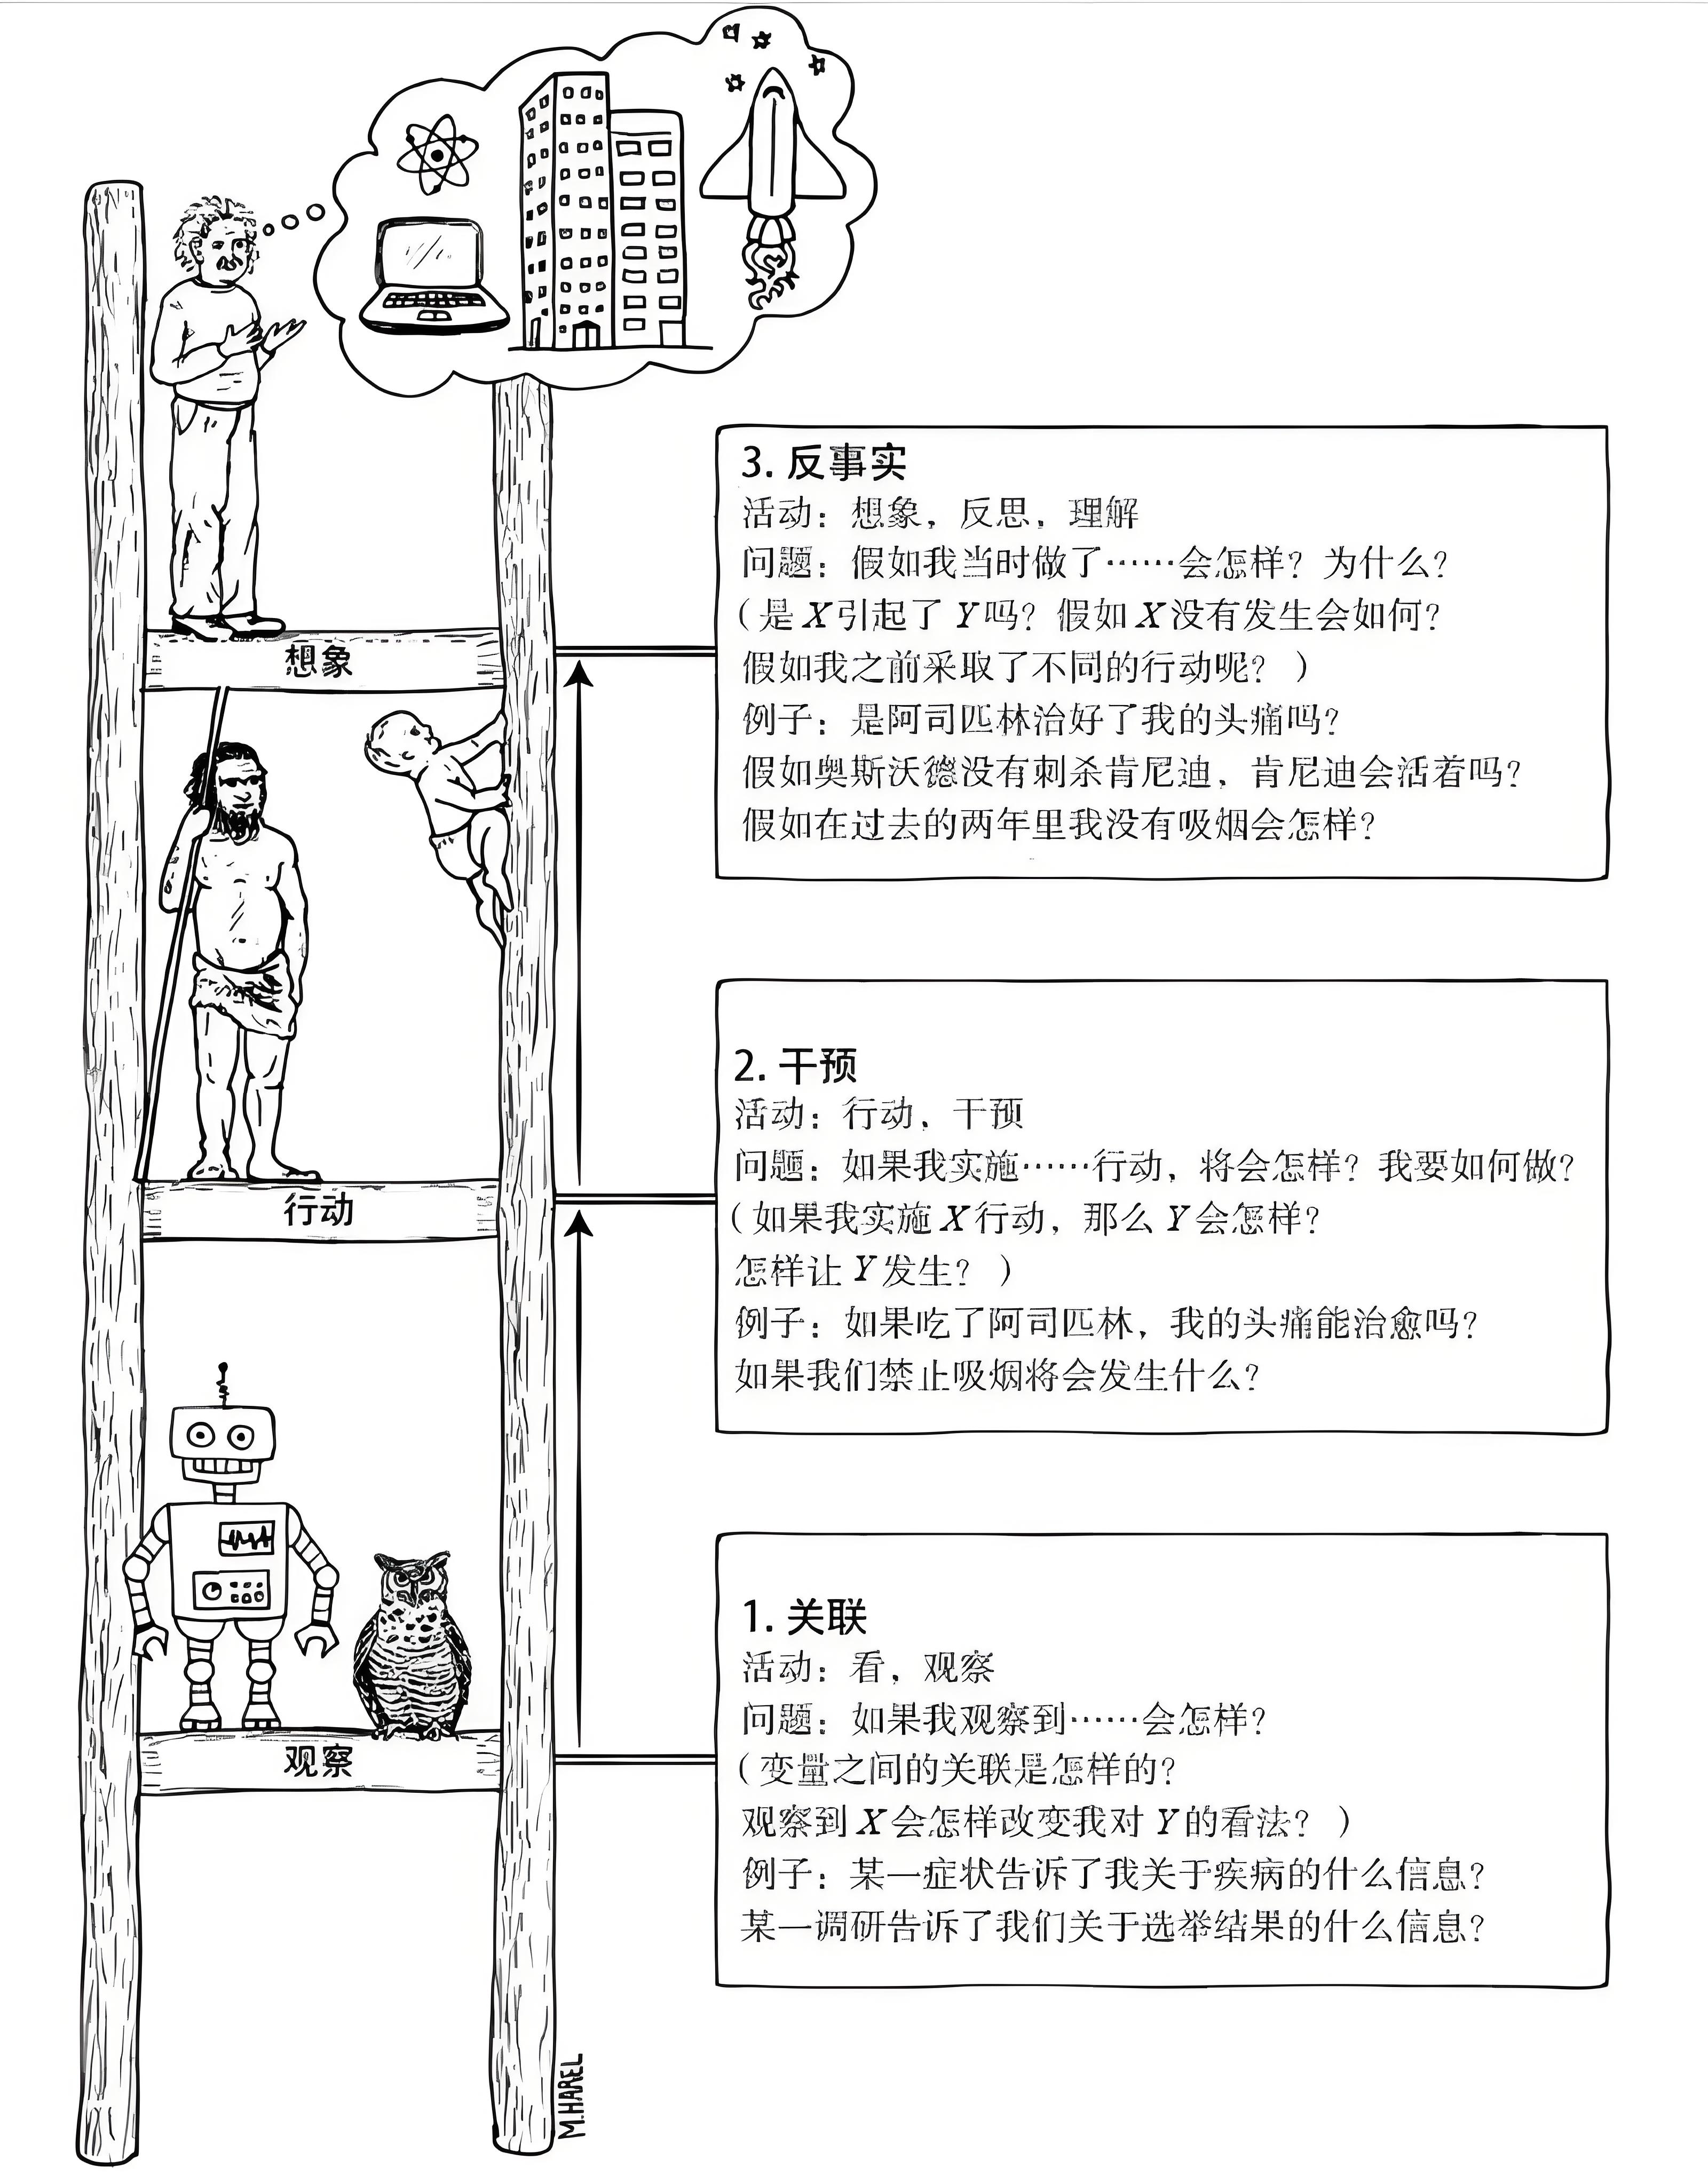
其中,区分第一、二层级的关键在于是否主动干预。在数学上,珀尔引入了do算子来表示这种区别: $do(X)$ 意味着“对X进行干预”,在因果图中表现为删除所有指向X的箭头、然后计算Y的分布。由此,
- 因果关系的第一层:对应条件概率 $P(Y∣X)$,即观察到 $X$ 取某个值时,$Y$ 的概率分布是什么
- 因果关系的第二层:对应干预概率 $P(Y∣do(X))$,即主动将 $X$ 设定为某个值时,$Y$ 的概率分布是什么
然而,现实中往往当存在混杂因素,使得上述两者不相等,无法通过统计方法直接测量条件概率实现对干预概率的估计。为了实现从关联到干预的层级跨越,因果推断的相关科学方法逐渐涌现。
从关联到干预——基础方法与工具
因果推断的核心障碍——混杂因素,它是一个同时影响“原因”和“结果”的变量,是导致非因果虚假关联的罪魁祸首。设 $X$ 为处理变量,$Y$ 为结果变量,那么同时影响两者的变量 $Z$ 就可以称为混杂因素,即:
$$Z → X,Z → Y$$
此时,若分析 $X$ 和 $Y$ 之间的关联,可以找出两条路径:
- $X → Y$
- $X ← Z → Y$ ,称作是后门路径
要想通过数据估计出 $X$ 对 $Y$ 的真实因果效应,就必须阻断后门路径,从而去除混杂因素。常见的方法是——随机对照试验:通过随机分配 $X$,使其与所有潜在混杂因子 $Z$ 相互独立。
然而,随机对照试验依赖对 $X$ 的人工干预(或偶然满足条件),在伦理、成本上不一定可行。从因果论的角度出发,在建立了完备因果图的基础上,可以通过统计手段阻断后门路径。由此,珀尔提出了后门准则:
- 如果存在一组变量 $Z$,能够阻断 $X$ 到 $Y$ 之间所有的后门路径,那么就能据此通过数据估计出 $X$ 对 $Y$ 的真实因果效应
在此条件下,因果效应可由调整公式计算:
$$ P(Y | do(X)) = \sum_Z P(Y | X, Z) P(Z) $$
其原理正是:通过充分控制混杂因素 $Z$,计算出$X$ 对 $Y$ 的真实因果效应。可以将其拆分为步骤进行理解:
- 将样本按混杂因素 $Z$ 的分布进行分层
- 在每一层内:计算 $X → Y$ 的条件概率
- 最终按 $Z$ 的分布加权平均
然而,这种方法并不总是能起作用。只有在建立出完备的因果模型时,才能通过采集数据、观测混杂因素 $Z$ 以估算真实效应。一旦混杂因素 $Z$ 无法被充分观测(比如其中的一个因素无法进行数据测量),就无法使用后门准则。
在这种情况(存在无法观测的混杂因子时)下,如果 $X → Y$ 的效应完全通过一个可观测的中介变量 $M$ 传递,那么可以采用前门准则作为替代方案进行估计。前门准则指的是:
- 如果 $X$ 到 $Y$ 的因果效应完全通过一个可观测的中介变量 $M$ 传递,且 $M→Y$ 之间不存在未观测的混杂时,仍然可以估计出真实的因果效应
在此条件下,因果效应可通过两步回归来进行计算:
$$ P(Y | do(X)) = \sum_M P(M | X) \sum_{X'} P(Y | M, X') P(X') $$
可以将其拆分为步骤进行理解:
- 先估计 $X$ 对 $M$ 的效应(这一段不受混杂因素影响)
- 再在控制 $X$ 的前提下,估计 $M$ 对 $Y$ 的效应,使其不受混杂因素影响
- 上述两者相乘后对 $M$ 求和
在实际应用中,仍然存在一些因果图,既无法使用后门调整,也无法使用前门调整。珀尔在1995年提出的do演算解决了这一局限,它可以将任何包含do算子的概率表达式转化为不含do算子的表达式(即:将包含干预变量的概率表达式转化为仅含观测变量的形式)。do演算由三条规则构成:
- 增删观测变量:如果在干预 $X$ 的条件下,$Z$ 对 $Y$ 没有额外信息,那么就可以把 $Z$ 从条件中删掉
- 互换干预变量与观测变量:如果 $Z$ 不影响 $X$,那么在控制 $Z$ 的前提下,“主动干预 $X$”等同于“被动观察到 $X$”,可以把 $do(X)$ 直接改写为普通的条件 $X$
- 增删干预变量:在已经干预 $X$ 的情况下,如果干预 $Z$ 不会影响 $Y$,就可以把 $do(Z)$ 删掉或换成普通的条件 $Z$
do演算的关键在于其完备性:如果一个问题在给定因果图下是可识别的,那么do演算的三条规则就一定能将其推导出来。换言之,后门准则和前门准则都是do演算在特定图结构下的特例,do演算由此构成了因果推断的基本框架。
从干预到反事实——进阶方法与工具
上述方法和工具,共同解决了因果之梯第二层的问题:如何从观测数据中估计干预效应。对于因果之梯的第三层——反事实,要回答的问题更为棘手:“如果当初做了不同的选择,结果会怎样?”这一类问题无法通过实验直接回答,因为历史无法重来。为了实现反事实推理,结构因果模型(Structural Causal Model, SCM)被引入作为数学基础。它由三部分组成:
- 外生变量 $U$:代表系统外部的随机扰动,不受系统内部任何变量影响
- 内生变量 $X$:系统内部的观测变量
- 结构方程 $f_i$:描述每个内生变量如何被系统内部直接原因 $PA_i$($X_i$ 的父节点)和系统外部外生扰动 $U_i$ 所决定
因果结构模型不仅包含图结构以描述变量间相互影响的关系,还包含响应函数 $f_i$ 、用以描述变量间如何影响彼此。因此,其一般形式为:
$$ X_i = f_i(PA_i, U_i) $$
在因果结构模型中,实现反事实推理的思路是:在同一个外生变量配置下,比较不同干预方案的结果。其步骤可以描述为:
- 保持所有外生变量不变:以符号 $u$ 表示
- 干预某个变量:将其结构方程替换为常数($X=x$)
- 计算修改后的模型中其他变量的取值:$Y_{X=x}(u) = f_Y(x, PA_Y, u)$
用珀尔的例子来说:“如果奥斯瓦尔德没有杀死肯尼迪,他还会活着吗?”在拥有完备的因果结构模型的前提下,这个问题应该按如下的思路进行反事实推理:
- 保持所有其他外生条件不变
- 将“奥斯瓦尔德开枪”这一变量的结构方程替换为“不开枪”
- 计算“肯尼迪是否存活”的取值
反事实推理的一个核心应用是归因:当结果已经发生,反过来追问某个原因是否“必要”或“充分”。珀尔为此引入了两个量化概念:
必要性概率(Probability of Necessity, PN),用以回答“如果没有 $X$,$Y$ 是否还会发生?”的问题,即:在已经观察到 $X=1$ 且 $Y=1$ 的情况下,如果当初 $X=0$,$Y=1$ 的概率是多少。因此可以表达为:
$$ PN = P(Y_{X=0} = 0 | X=1, Y=1) $$
充分性概率(Probability of Sufficiency, PS),用以回答“如果有了 $X$,$Y$ 是否一定会发生?”的问题,即:在已经观察到 $X=0$ 且 $Y=0$ 的情况下,如果当初 $X=1$,$Y=1$ 的概率是多少。因此可以表达为:
$$ PS = P(Y_{X=1} = 1 | X=0, Y=0) $$
这两个概念可以应用在实际中,例如:下面的两个问题都可以通过计算必要性概率进行回答:
- 法庭上:如果被告没有做某事,伤害是否还会发生?
- 医学上:如果患者没有暴露于某风险因素,疾病是否还会出现?
Discussion:从因果推断到人工智能
作者提到:强人工智能的目标是制造出拥有类人智能的机器,让他们能与人类交流、指导人类的探索方向。当今AI已经涌现出LLM、基于LLM的Agent等先进技术,能够一定程度上与人类交流、调用工具帮助人类执行任务,那么为什么说当今AI还没有实现这一目标?
其一,从当今AI的理论基础来说:正如珀尔提到“深度学习领域所有令人印象深刻的成就都只是曲线拟合而已。”从数学上看,深度学习的核心是通过最小化损失函数来拟合参数:
$$ \min_\theta \mathbb{E}_{(x,y) \sim P_{data}}[L(f_\theta(x), y)] $$
本质上:这是在拟合数据分布 $P_{data}$ 中的条件期望 $E[Y|X]$,而因果推断要求的是 $E[Y|do(X)]$。当存在混杂因素时,这两者是不能划等号的。因此,从数学基础上就决定了:即使一个模型在预测任务上表现地再好,也无法回答“如果我改变 $X$,$Y$ 会怎样”的因果问题。
其二,从因果推断的本质来说:因果推断是人类本身的能力,人类智能的独特之处正在于拥有可操纵的现实模型(mental representation),能回答“如果……会怎样”这类问题。当今AI缺乏现实模型,仍然只是在拟合数据中的关联。LLM等技术,可能通过隐式方式习得了部分因果结构,但这些能力“相当一部分能力来自训练数据中已经存在的人类知识、解释和推理过程”,并不是通过模型自身与世界互动而建立的。因此,当今AI的因果推断能力也只是对训练数据中因果模式的高阶模仿,距离强人工智能还有一定的距离。
在通往AGI、通往强人工智能的路上,为机器赋予因果推断能力,就是在模拟人本身的因果推断过程。正如珀尔提到:通过实现自我模拟来实现强人工智能,同时也是在了解人类自身。开发AI的过程,就是模拟我们自身、也是学习自身的过程。
为防止机器人刷评,请输入验证码~
验证码可能加载较慢,请耐心等待 | 点击图片可刷新验证码